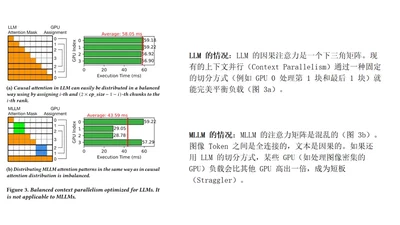
Cornstarch:面向多模态大模型的高效分布式训练系统
面向多模态大模型训练的分布式系统,感知层冻结状态以消除流水线气泡,并为混合注意力模式设计跨 GPU 与 GPU 内的 token 工作负载均衡上下文并行,同时自适应地将模态编码器与 LLM 并行配置组合以最大化吞吐。

面向多模态大模型训练的分布式系统,感知层冻结状态以消除流水线气泡,并为混合注意力模式设计跨 GPU 与 GPU 内的 token 工作负载均衡上下文并行,同时自适应地将模态编码器与 LLM 并行配置组合以最大化吞吐。
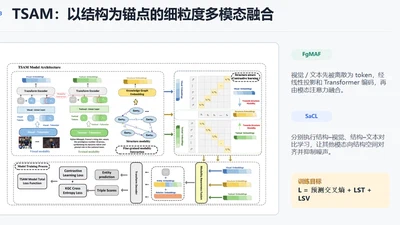
以结构表示为锚点的细粒度多模态融合框架,将视觉与文本离散为 token 并统一到共享空间,通过双向对比学习让多模态向结构空间对齐,保持结构模态的主导地位。

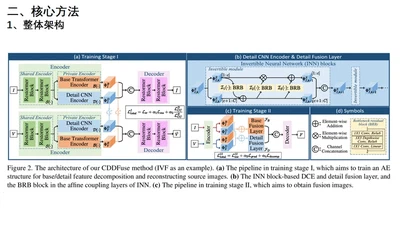
面向多模态图像融合的 Transformer-CNN 双分支框架,用 Restormer、轻量 Transformer 与可逆神经网络分别提取模态共享的低频基特征和模态特有的高频细节特征,并通过相关性驱动的分解损失强制分解,在红外-可见光与医学图像融合任务上取得领先性能。

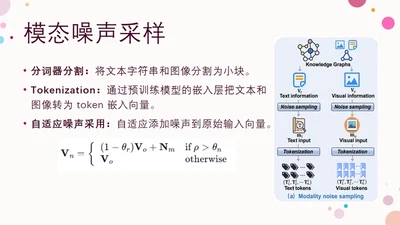
面向多模态知识图谱补全,将自适应噪声采样与注意力惩罚策略相结合,缓解注意力过度信任问题,提升模型对噪声数据的鲁棒性。
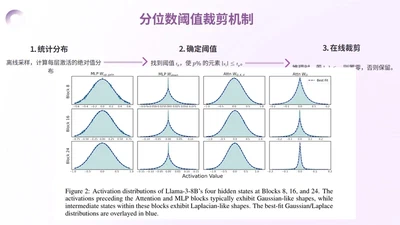
面向大模型推理的无训练激活稀疏方法,通过分位数阈值裁剪低幅值激活、块级贪心分配稀疏预算,在约 50% 稀疏度下保持高精度并实现单 batch 解码 1.5-1.8× 加速,且与权重量化正交可叠加。
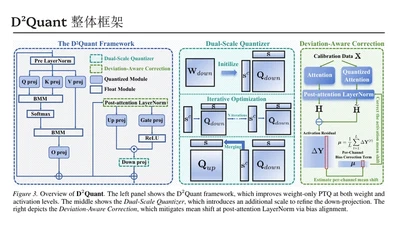
面向大语言模型 sub-4-bit 权重量化,通过 Dual-Scale Quantizer 为 down-projection 引入额外列缩放,并用 Deviation-Aware Correction 校正 post-attention LayerNorm 的均值偏移,在 Qwen-3 与 LLaMA-3 系列上显著提升 2-bit 量化精度。
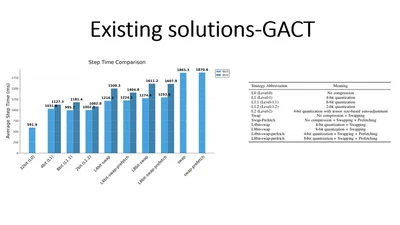
面向显存高效 DNN 训练,将量化卸载与流水线预取结合,让数据传输与前后向计算重叠,缓解 CPU-GPU 通信瓶颈。

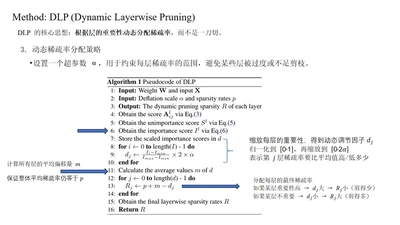
面向大语言模型的动态层级剪枝方法,用权重与激活的中位数度量层不重要性并生成相对重要性分布,动态分配各层稀疏率,在 70% 稀疏率下显著优于 Uniform 与 OWL。
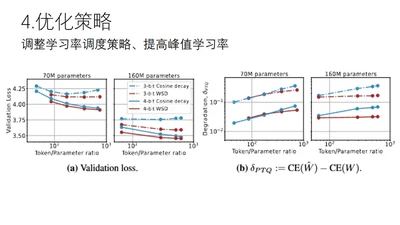
重新审视训练数据量增加导致量化退化的现象,指出其本质是训练动力学(学习率调度与损失景观平坦度)所致,并给出提高峰值学习率、采用 WSD 调度以及权重平均(LAWA、Model Soup)等策略,显著提升 3-bit/4-bit PTQ 的鲁棒性。

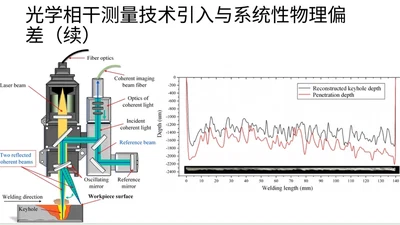
面向不锈钢薄板激光搭接焊的 OCT 熔深监测框架,结合 EMD 自适应重构与 LSTM 时序补偿,攻克 6.8ms 物理迟滞与多次反射测量偏差难题。