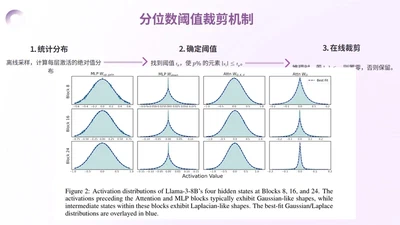
TEAL:无训练激活稀疏加速大模型推理
面向大模型推理的无训练激活稀疏方法,通过分位数阈值裁剪低幅值激活、块级贪心分配稀疏预算,在约 50% 稀疏度下保持高精度并实现单 batch 解码 1.5-1.8× 加速,且与权重量化正交可叠加。
肖洋
面向大模型推理的无训练激活稀疏方法,通过分位数阈值裁剪低幅值激活、块级贪心分配稀疏预算,在约 50% 稀疏度下保持高精度并实现单 batch 解码 1.5-1.8× 加速,且与权重量化正交可叠加。
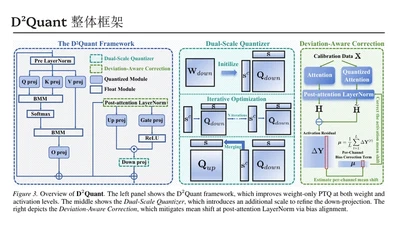
面向大语言模型 sub-4-bit 权重量化,通过 Dual-Scale Quantizer 为 down-projection 引入额外列缩放,并用 Deviation-Aware Correction 校正 post-attention LayerNorm 的均值偏移,在 Qwen-3 与 LLaMA-3 系列上显著提升 2-bit 量化精度。
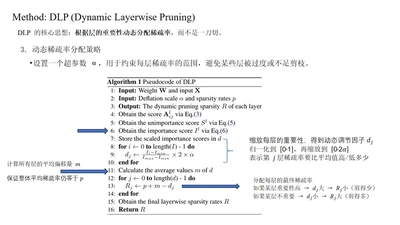
面向大语言模型的动态层级剪枝方法,用权重与激活的中位数度量层不重要性并生成相对重要性分布,动态分配各层稀疏率,在 70% 稀疏率下显著优于 Uniform 与 OWL。
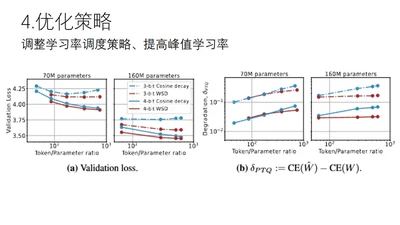
重新审视训练数据量增加导致量化退化的现象,指出其本质是训练动力学(学习率调度与损失景观平坦度)所致,并给出提高峰值学习率、采用 WSD 调度以及权重平均(LAWA、Model Soup)等策略,显著提升 3-bit/4-bit PTQ 的鲁棒性。

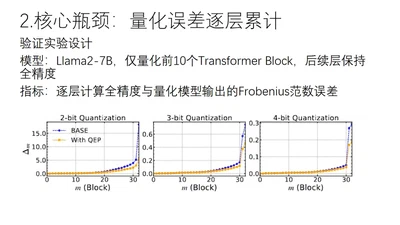
重新审视逐层 PTQ 的框架,显式建模跨层量化误差传播,利用上游累积的激活量化误差对当前层权重做补偿矫正,并通过可控缩放因子抑制过拟合,在 Llama 与 Mistral 系列上 INT2/INT3/INT4 精度均优于 RTN、GPTQ、AWQ 与 QuIP。
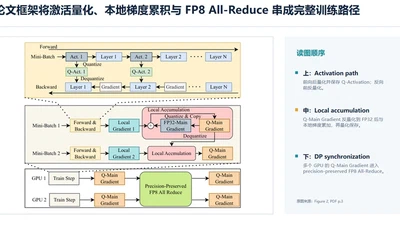
面向 LLM 训练的系统级低比特框架,联合压缩激活存储、梯度存储与梯度通信,只对误差最敏感的操作保持高精度,显著降低训练显存与 DP 通信开销。

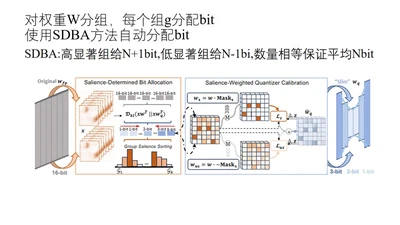
面向低比特 LLM 压缩的分组格型矢量量化方法,先按权重显著性用 SDBA 自适应分配比特,再为每个权重组学习生成矩阵与组专属压扩参数,通过 Babai 格型取整与基于校准输入的端到端重构误差优化码本,在 Llama 系列上优于 OmniQ、QuIP#、QTIP 等基线。
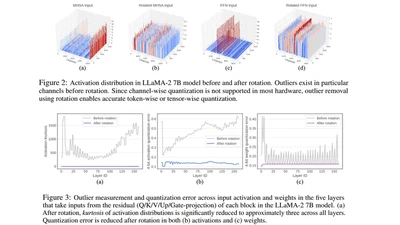
利用 Transformer 残差流的旋转不变性,将旋转矩阵作为可训练参数学习,以打散激活与权重中的异常值分布,相比随机 Hadamard 旋转显著降低量化误差并提升低比特量化精度。

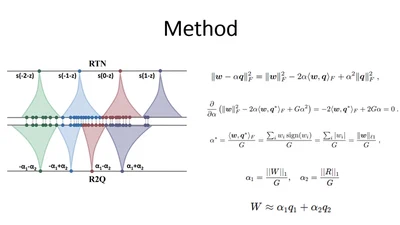
将 2 比特量化过程分解为两次连续的 1 比特量化,形成自适应量化格网,显著缓解大语言模型在超低比特下的精度损失。