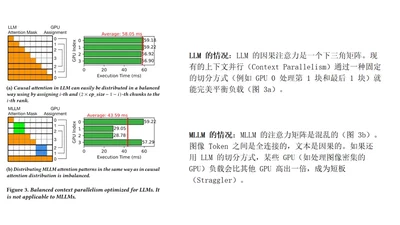
Cornstarch:面向多模态大模型的高效分布式训练系统
面向多模态大模型训练的分布式系统,感知层冻结状态以消除流水线气泡,并为混合注意力模式设计跨 GPU 与 GPU 内的 token 工作负载均衡上下文并行,同时自适应地将模态编码器与 LLM 并行配置组合以最大化吞吐。

面向多模态大模型训练的分布式系统,感知层冻结状态以消除流水线气泡,并为混合注意力模式设计跨 GPU 与 GPU 内的 token 工作负载均衡上下文并行,同时自适应地将模态编码器与 LLM 并行配置组合以最大化吞吐。
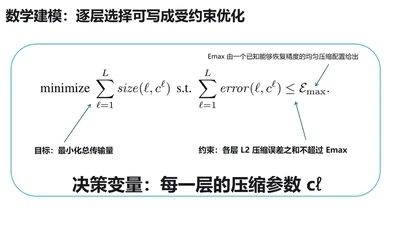
将逐层压缩参数选择建模为受约束优化问题并通过动态规划求解,在同等精度下实现最高 5.2 倍的梯度压缩率,显著缓解分布式训练的通信瓶颈。

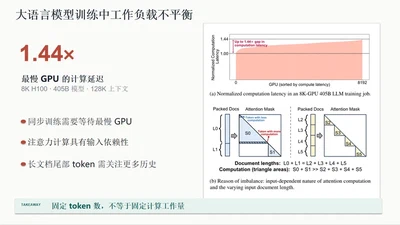
面向长上下文 LLM 训练的负载均衡型 4D 并行方法,通过在 PP 层做变长打包与 outlier delay、在 CP 层做 Per-Doc 分片与自适应选择,把调度单位从 token 数转向真实 workload,实现平均 1.23× 端到端加速且不改变收敛趋势。

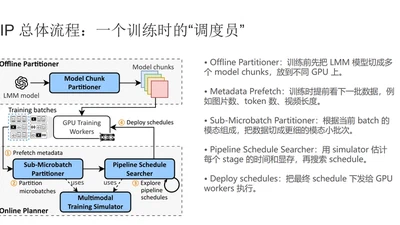
面向 LMM 训练的动态交错流水线系统,通过模态分离切分消除段内不均衡、按模态拆分子微批次缓解段间不均衡,并用基于 MCTS 的调度搜索器与代价模拟器在线寻找近似最优流水线调度,在 GPU 训练的同时完成搜索而不拖慢训练。
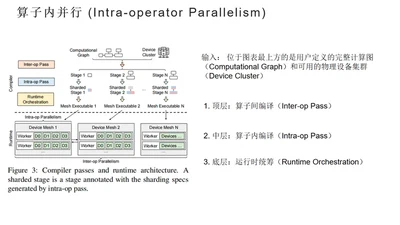
面向分布式深度学习的自动并行系统,将算子内并行与算子间并行统一到一个分层搜索空间中,用动态规划划分流水线阶段、用整数线性规划求解算子内切分方案,可跨模型结构与集群拓扑泛化。
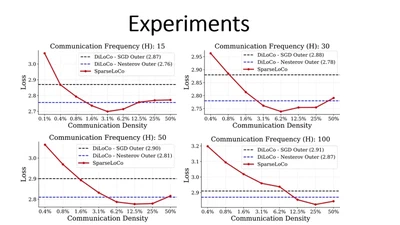
在 DiLoCo 低频同步框架之上,对伪梯度进行 Top-k 稀疏化与 2-bit 量化,并结合误差反馈,显著降低大模型预训练的分布式通信开销。