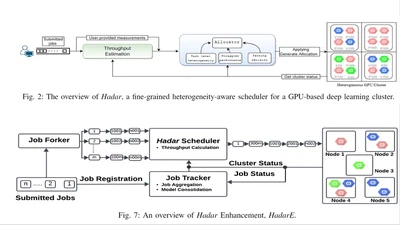
面向深度学习集群的资源异构感知与利用率增强调度
面向 GPU 深度学习集群的增强型异构感知调度器,通过动态规划在线分配把训练作业分叉到多个节点上执行,相比 Hadar 与 Gavel 显著提升集群资源利用率并缩短作业完成时间。

面向 GPU 深度学习集群的增强型异构感知调度器,通过动态规划在线分配把训练作业分叉到多个节点上执行,相比 Hadar 与 Gavel 显著提升集群资源利用率并缩短作业完成时间。
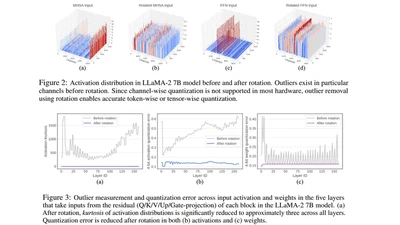
利用 Transformer 残差流的旋转不变性,将旋转矩阵作为可训练参数学习,以打散激活与权重中的异常值分布,相比随机 Hadamard 旋转显著降低量化误差并提升低比特量化精度。

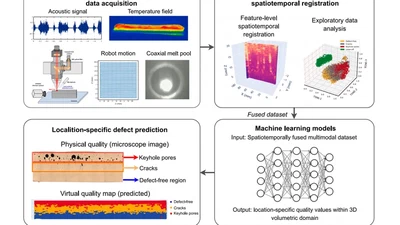
面向机器人激光定向能量沉积的多传感器融合数字孪生方法,融合同轴视觉、SWIR热场与声学传感,突破单一模态感知盲区,实现位置特异性质量预测。
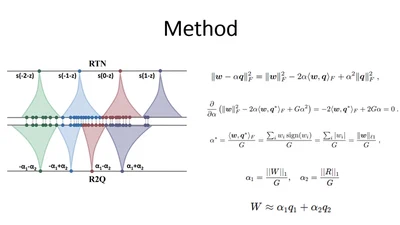
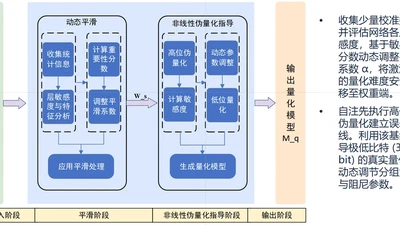
将 2 比特量化过程分解为两次连续的 1 比特量化,形成自适应量化格网,显著缓解大语言模型在超低比特下的精度损失。

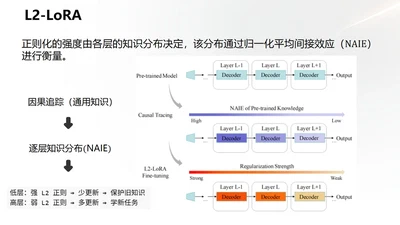
具备层感知能力的 LoRA 变体,基于因果追踪得到的层级知识分布 NAIE 为每层分配不同的 L2 正则化强度,对存储通用知识的低层强正则化以保护旧知识,对存储任务特定知识的高层弱正则化以学习新任务。

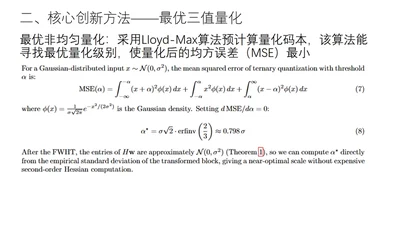
面向大语言模型的高保真 3-bit 量化与推理框架,用快速沃尔什-哈达玛变换将重尾权重分布平滑为近似高斯分布,基于 Lloyd-Max 推导最优三值量化阈值,并把逆 FWHT 融合进 MMQ CUDA 核,避免去量化权重落到全局内存。

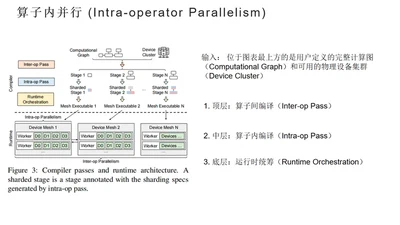
面向分布式深度学习的自动并行系统,将算子内并行与算子间并行统一到一个分层搜索空间中,用动态规划划分流水线阶段、用整数线性规划求解算子内切分方案,可跨模型结构与集群拓扑泛化。

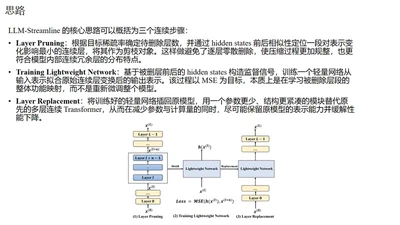
面向大语言模型的层级剪枝与轻量替代方法,用输入输出 hidden states 的余弦相似度定位连续冗余层,并训练轻量 FFN 替代被剪层段,在约 25% 剪枝率下保留原模型约 93% 的分类能力。
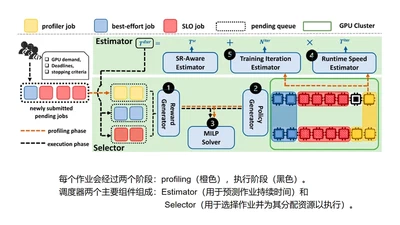
面向 GPU 集群的统一调度系统,通过 Estimator 与 Selector 组件和基于租约的执行机制,同时覆盖严格/软 SLO 与尽力而为作业的调度时延需求,以及迭代/性能两类停止条件。
