Distributed Training

Cornstarch: Efficient Distributed MLLM Training with Frozen-Aware Parallelism and Balanced Context Parallelism featured image

Cornstarch: Efficient Distributed MLLM Training with Frozen-Aware Parallelism and Balanced Context Parallelism

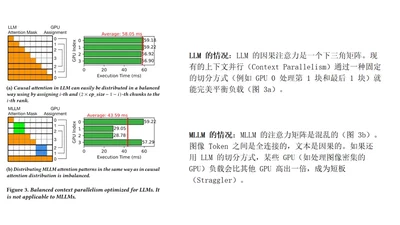
A distributed MLLM training system that makes pipeline parallelism frozen-status aware to eliminate bubbles, introduces token workload-balanced context parallelism for the mixed …

avatar
Hao Yao
•
L-GreCo: Layerwise-Adaptive Gradient Compression for Efficient and Accurate Deep Learning featured image

L-GreCo: Layerwise-Adaptive Gradient Compression for Efficient and Accurate Deep Learning

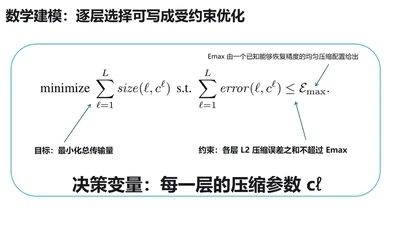
A layerwise-adaptive gradient compression framework that formulates per-layer compression parameter selection as a constrained optimization and solves it via dynamic programming, …

avatar
Jiaqi Li
•
WLB-LLM: Workload-Balanced 4D Parallelism for Large Language Model Training featured image

WLB-LLM: Workload-Balanced 4D Parallelism for Large Language Model Training

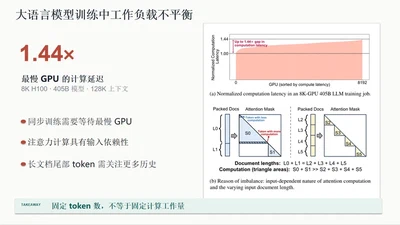
A workload-balanced 4D parallelism method for long-context LLM training that combines variable-length packing and outlier delay at the PP level with per-document sharding and …

avatar
Yuliang Yang
•
DIP: Efficient Large Multimodal Model Training with Dynamic Interleaved Pipeline featured image

DIP: Efficient Large Multimodal Model Training with Dynamic Interleaved Pipeline

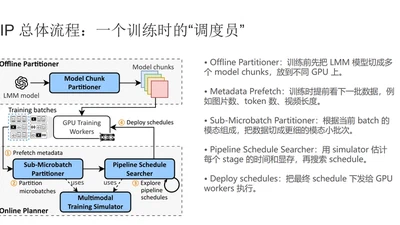
A dynamic interleaved pipeline system for LMM training that separates modality segments to remove intra-segment imbalance, splits data into modality-aware sub-microbatches to …

avatar
Hao Yao
•
Alpa: Automating Inter- and Intra-Operator Parallelism for Distributed Deep Learning featured image

Alpa: Automating Inter- and Intra-Operator Parallelism for Distributed Deep Learning

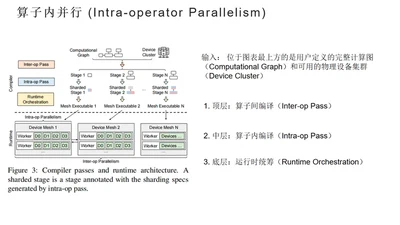
An automatic parallelization system for distributed deep learning that unifies intra-operator and inter-operator parallelism in a hierarchical space, using dynamic programming for …

avatar
Hao Yao
•
SparseLoCo: Communication Efficient LLM Pre-training with Sparsity-driven Data Synchronization featured image

SparseLoCo: Communication Efficient LLM Pre-training with Sparsity-driven Data Synchronization

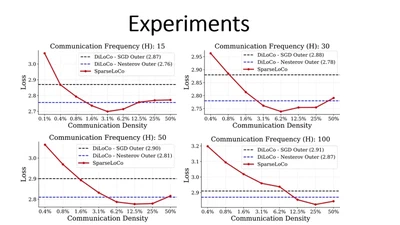
A sparse pseudo-gradient compression method for communication-efficient distributed LLM pre-training, combining Top-k selection, aggressive 2-bit quantization and error feedback on …

avatar
Jiaqi Li
•

Distributed Machine Learning & System Optimization

Communication optimization, heterogeneous GPU scheduling, and large-scale training acceleration for distributed deep learning.